割り込み可能な対話型音声AI
中国語と英語の音声アシスタントが、ハードウェアアクセラレーションで端末上でその場で聞き取って答えます。
デバイス上で応答し、応答中でも割り込める音声端末。聞き取りと発話はローカルで完結し、対話モデルは自前のクラウドエンドポイントかオンデバイスのどちらか。reComputer RK、reComputer J30 / J40(Orin)、reComputer R2000 シリーズで動作し、対話言語はデプロイ時に固定される。
再利用できる現場テンプレート
立ったまま声で操作し、手がふさがっていて、誤った回答をすぐ遮れる必要がある場所。
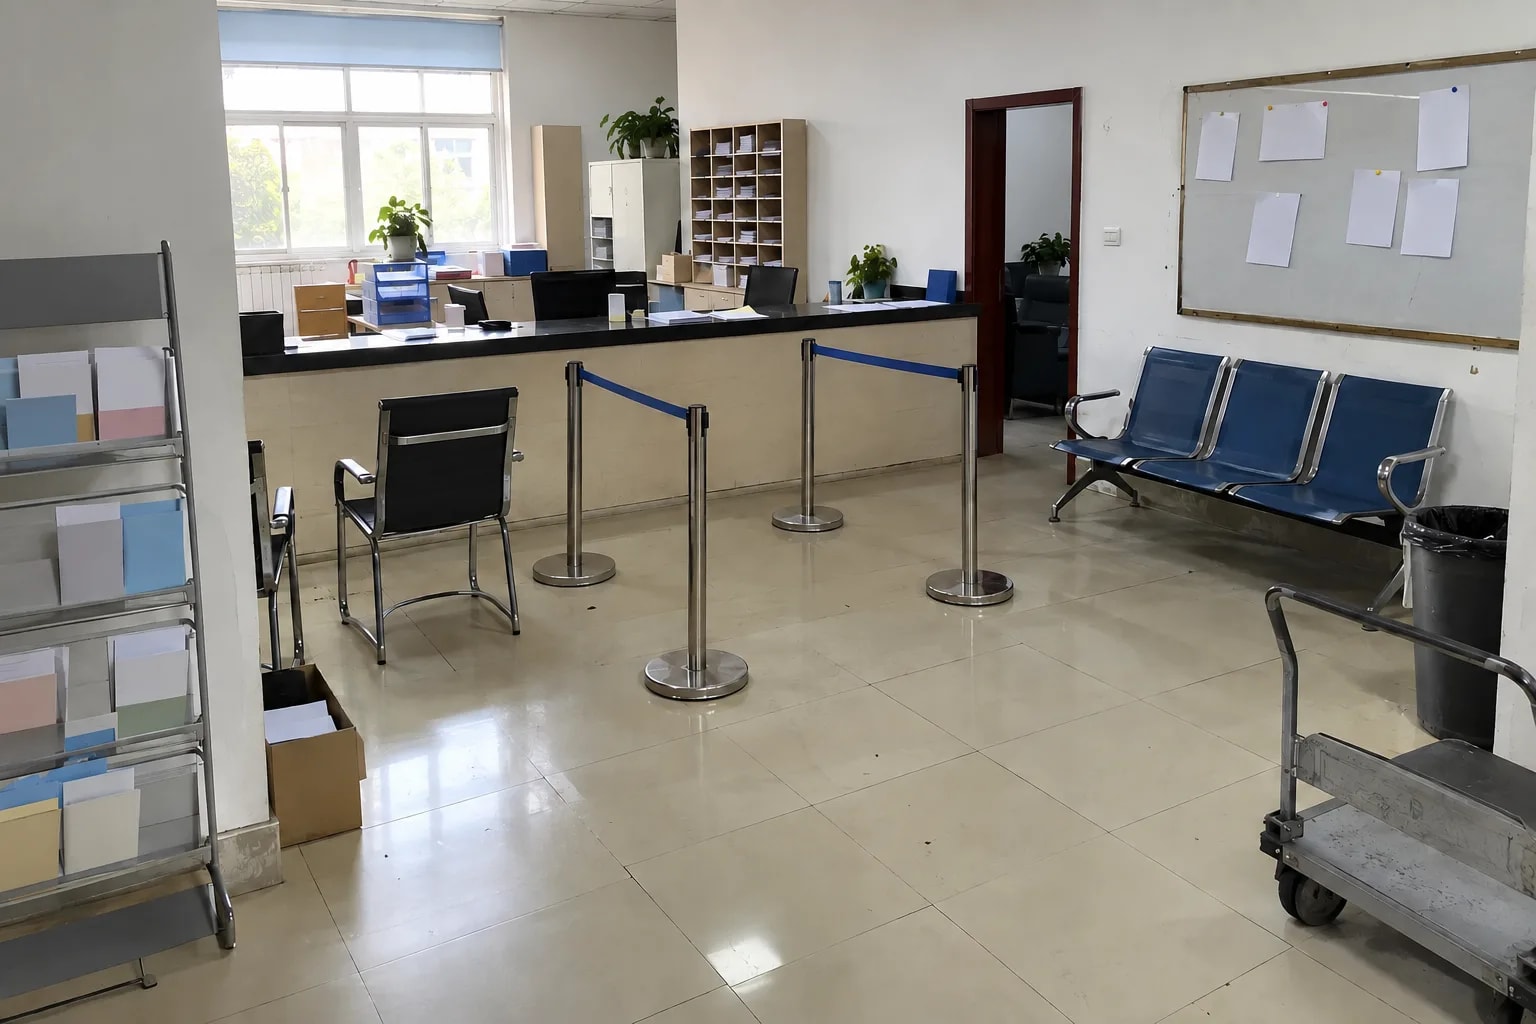
受付カウンターと展示ブース
行政窓口の案内カウンター、展示会のブース、店舗の接客カウンター。回答がずれたら割り込んで聞き直せます。
ロボットや装置の音声入力
卓上ロボット、配送ロボット、工場の操作卓。背後のモデルを入れ替えても、この層はそのまま使えます。
部屋と家庭用端末
リビング、会議室、ホテル客室。離れた位置からの発話に対応し、自分の再生音では起動しません。
適さない条件:ハードウェアエコーキャンセラーのないマイク。reComputer R2000 シリーズ上での中国語。
どう実現するか
マイクアレイが音声を取得し、エッジ音声ホストが認識と合成を行い、スピーカーが応答を再生します。対話モデルは同じホスト上、または自社のエンドポイントで動作します。
4 つの要素があります。ハードウェアですでにエコーを除去したマイクアレイ、スピーカー、認識・合成・常駐エージェントを実行するエッジボード 1 台、そして API の先か同じボード上のどちらかに位置する対話モデル 1 つです。最初の 3 つは常に現場にあります。外部ネットワークを経由するかどうかは、4 つ目だけで決まります。
On-Site Capture
マイクは必須要件です。 ハードウェアですでにエコーを除去した採取チャンネルを備えている必要があります。普通の USB マイクではスピーカーの音を再度拾ってしまい、端末が自分の発話に割り込み始めます。
- reSpeaker XVF3800 が検証済みの既定選択です。USB 接続でハードウェアエコーキャンセル、ノイズ抑制、ビームフォーミングを行い、処理済みチャンネルが自動で選択されます。
- 他のアレイは最初の採取チャンネルにフォールバックし、現場での音響確認が必要です。
- USB または 3.5mm スピーカーが応答を再生します。再生中にマイクをミュートすると、エコーと同時に割り込み発話(バージイン)もできなくなります。
マイクはエージェント動作中に抜き差し可能で、採取は再起動なしに復帰します。
Voice Host
1 台のボードが認識・合成・常駐エージェントを実行し、対応できる言語もこのボードで決まります。
| 音声ホスト | 中国語 | 英語 | その他 28 言語 | ローカル対話モデル |
|---|---|---|---|---|
| reComputer RK3576 | Qwen3-ASR W8A8 + Matcha | Qwen3-ASR W8A8 + Matcha | 非対応 : このボードの TTS は Matcha zh-en のみ | なし |
| reComputer RK3588 | Qwen3-ASR W8A8 + Matcha | Qwen3-ASR W8A8 + Matcha | Qwen3-ASR + Kokoro RKNN | RK1828 / RM182X カード追加で対応 |
| Jetson Orin Nano 8GB | Qwen3-ASR int4 + Matcha | Qwen3-ASR int4 + Matcha | Qwen3-ASR + Qwen3-TTS | なし : Nano で 4B モデルを起動しないこと |
| Jetson Orin NX 16GB | Qwen3-ASR int4 + Matcha | Qwen3-ASR int4 + Matcha | Qwen3-ASR + Qwen3-TTS CustomVoice | Qwen3.5-4B を音声と同時実行 |
| reComputer R2000 シリーズ | 拒否 | sherpa-onnx CPU | 非対応 | なし |
ボードが対応できない言語では、デプロイがそこで止まります。 reComputer R2000 シリーズで中国語を選ぶと、CER 35〜56% で読む水準のモデルに渡すのではなく拒否されます。マトリクス 18 セルのうち、実測 5 セル、デプロイ可能だが未計測 10 セル、拒否 3 セルです。完全な一覧は工程 Wiki にあります。
Playback & Conversation Model
データが現場の外に出るかどうかを決める、唯一の選択がこれです。
| ルート | 実行主体 | 必要条件 |
|---|---|---|
| クラウドまたは OpenAI 互換エンドポイント | 既定は Qwen API、または任意のエンドポイント・キー・モデルを入力 | 常時インターネット接続、有効なキー、ストリーミング Chat Completions |
| オンデバイス、RK ルート | RK3588 ホスト配下の RK1828 / RM182X カード上で Qwen3-4B を実行 | カード用の独立 12V 電源とドライバ。1 カードにつき常駐モデル 1 つ |
| オンデバイス、Jetson ルート | Orin NX 16GB 上で Qwen3.5-4B を音声処理と同居実行 | JetPack 6.2、空き容量 25 GB 以上、他の GPU コンテナなし |
3 つのルートはいずれも同じ OpenAI 互換インターフェースを使うため、切り替えてもモデルのアドレスが変わるだけです。初回のオンライン起動でイメージとモデルをキャッシュした後は、オンデバイスのルートはネットワーク切断状態で動作します。データインターフェースは下の「何が取り出せるか」を参照してください。
どこまでできるか
起動後、ブラウザのパネルに会話全体が流れる。
実測データ
2 種類のボードで実測しています。行に明記がない限り、対話モデルは経路に含みません。
| 利用者が体感するもの | 代表値 | 機器 | モデルを含む |
|---|---|---|---|
| 発話終了から応答音声の先頭フレームまで | 800 ms 未満 | reComputer J40 Series | はい |
| 発話終了から応答音声の先頭フレームまで | 100 ms p50 | reComputer J40 Series | いいえ |
| 発話終了から応答音声の先頭フレームまで | 約 1.6 秒 | reComputer RK3576 | いいえ |
| 発話終了からテキスト結果まで | 16 ms p50 | reComputer J40 Series | いいえ |
| 中国語の認識誤り率(短い発話) | 1.05% CER | reComputer RK3576 | —— |
| 英語の認識誤り率(短い発話) | 3.65% WER | reComputer RK3576 | —— |
モデルを含まない行には、接続する対話モデルの応答時間を加えてください。クラウドのエンドポイントではネットワークの往復時間にも左右されます。10〜20 秒の長い発話では、認識誤り率が中国語 9.62% CER、英語 6.99% WER まで上がります。
セッションは最初の自然な区切りで応答します。 ターン検出は最短 2.5 秒の後、400 ms の無音を待つため、途中に間のある長い文では最初の節の時点で応答が返ります。機器ごとの音声認識・合成遅延マトリクスは エンジニアリング Wiki · 対話型音声 AI ソリューション を参照してください。
何が取り出せるか
すべて音声ホスト自身が提供します。対話モデルの向き先を外部にしない限り、クラウドには何も送られません。
| インターフェース | 動作場所 | 内容 |
|---|---|---|
ws://<host>:8621/v2v/stream | 音声サービス、全プリセット | 双方向セッション:PCM を入力し、文字起こしと合成音声を出力。割り込み時の中断通知も含みます |
POST http://<host>:8621/asr | 音声サービス | ファイル全体のオフライン文字起こし。上記の精度はここで測定しています |
POST http://<host>:8621/tts | 音声サービス | 音声合成。リアルタイム係数をレスポンスヘッダーで返します |
http://<host>:18000 | エージェント | Web ダッシュボード : 待機/思考中/発話中/割り込み済みの状態と、各ターンの文字起こし |
http://<host>:1828/v1 | RK1828 カード、RK ローカルプリセット | オンデバイスの Qwen3-4B 向け OpenAI 互換 Chat Completions |
http://<host>:8000/v1 | Orin NX、Jetson ローカルプリセット | オンデバイスの Qwen3.5-4B 向け OpenAI 互換 Chat Completions |
| 対話モデルのアドレス(外向き) | クラウドプリセット | 任意の OpenAI 互換エンドポイント。既定は Qwen API |
統合点はメッセージのトピックではなく、対話モデルのインターフェースです。 モデルのアドレスを自社サービス(エージェントフレームワーク、RAG エンドポイント、ロボットのコマンド層など)に向ければ、音声層はそのまま使えます。
自社システムへの移植
再利用できる単位は「ハードウェアエコーキャンセル付きの集音 → ローカル認識 → OpenAI 互換の呼び出し 1 本 → ローカル合成 → 割り込み可能な再生」というチェーンです。製品の中身に紐づくのは 1 区間だけで、それは URL の背後にあります。
| レイヤー | 移植時に必要な作業 |
|---|---|
| マイクの選定、チャンネル検出、ホットプラグ復帰 | そのまま再利用 |
| 4 種類のアクセラレータランタイム上の Qwen3-ASR と Matcha-TTS | そのまま再利用 |
| 双方向セッション、割り込み、再生バッファの排出 | そのまま再利用 |
| 言語とボードの対応チェックと、非対応の組み合わせの拒否 | そのまま再利用 |
| 対話モデルのアドレスの先にあるサービス | ここが自社製品の中身になります |
| システムプロンプトと応答の長さのポリシー | 新しいタスクに合わせて調整 |
ストリーミングの Chat Completions を話せるものはそのまま接続できます:自社文書に対する RAG サービス、ツール呼び出しを持つエージェントフレームワーク、ロボットのコマンド層、チケットや受注のバックエンドなど。
適さない形態
- ウェイクワードだけの機器。 押して話すタイプや単一コマンドの機器では、常時受聴のセッションと割り込みはコストに見合いません。
- レイテンシの保証値が必要な導入。 上記の数値は各行が示すボードとモデルに対するものです。自社の構成でエンドツーエンドに実測してください。
- 30 言語のカタログ外の言語、および reComputer R2000 シリーズでの中国語。いずれも導入時に拒否されます。
どう導入するか
現場の状況をお聞かせください。ハードウェアはこちらで選び、その後データ接続と手順に進みます。
構成を選ぶ
現場の状況をお聞かせください。ハードウェアはこちらで選びます。
言語
利用者はどの言語で話しかけますか?ボード側がその言語を認識し、かつ話し返せる必要があります。すべてのボードがすべての言語に対応するわけではありません。
構成を選ぶ
現場の状況をお聞かせください。ハードウェアはこちらで選びます。
クラウド / OpenAI 互換 LLM —— RK3576
ローカル音声スタック一式が動く最小コストのボードで、公開済みのベンチマークを持つ唯一のボードです —— 短い中国語発話で 1.05% CER、TTS はリアルタイムの 0.2 倍。中国語と英語のみに対応し、対話モデルは API 呼び出しです。
硬件/物料名称 数量 型号/SKU 说明 reComputer RK3576 1 100052518 - reSpeaker XVF3800 USB 4 マイクアレイ 1 101991441 - クラウド / OpenAI 互換 LLM —— RK3588
RK3576 が話せない他の 28 言語に対応します。このボードは Kokoro RKNN で合成します。対話モデルは同じくクラウドです。後から RK1828 カードを追加して完全ローカル対話に移行できるホストでもあります。
硬件/物料名称 数量 型号/SKU 说明 reComputer RK3588 1 100071234 - reSpeaker XVF3800 USB 4 マイクアレイ 1 101991441 - クラウド / OpenAI 互換 LLM —— Orin Nano 8GB
別の AI 処理と共有するボード向けです。音声スタックを Orin Nano の GPU で動かし、隣に視覚モデルを置く余力を残します。Nano 上でローカルの 4B モデルは起動しないでください。ここでの対話モデルは API 呼び出しのままです。
硬件/物料名称 数量 型号/SKU 说明 reComputer Super J3011 1 114110312 - reSpeaker XVF3800 USB 4 マイクアレイ 1 101991441 - 完全ローカル対話 —— Orin NX 16GB
Qwen3.5-4B を Qwen3-ASR・Matcha-TTS と同じボードで動かすため、初回起動で成果物をキャッシュした後は何も現場外に出ません。JetPack 6.2 と 25 GB 以上の空き容量が必要です。もう 1 つの完全ローカル構成(RK3588 + RK1828 / RM182X カード)は導入ガイドでは対応していますが、見積もり用の購入プロファイルがありません。
硬件/物料名称 数量 型号/SKU 说明 reComputer Super J4012 1 114110314 - reSpeaker XVF3800 USB 4 マイクアレイ 1 101991441 -
自分で比べる:各構成のスペック対照デプロイガイド · 30min →
パッケージ別ハードウェア一覧
| 構成 | 役割 | 機材 | 数量 |
|---|---|---|---|
| クラウド or OpenAI 互換モデル | Compute Device | reComputer RK3576 シリーズ / reComputer RK3588 シリーズ / reComputer J30 シリーズ(Jetson Orin Nano) / reComputer J40 シリーズ(Jetson Orin NX) / external_raspberry_pi_5(いずれか) | 1 |
| AEC Microphone | reSpeaker XVF3800 4マイクアレイ | 1 | |
| 完全ローカル対話 | Local AI Device | reComputer RK3588 シリーズ / reComputer J40 シリーズ(Jetson Orin NX)(いずれか) | 1 |
| AEC Microphone | reSpeaker XVF3800 4マイクアレイ | 1 |
技術仕様・実装パスの比較
| プリセット | 対話モデル | 対応する音声ホスト | オフライン動作 | 適する用途 |
|---|---|---|---|---|
| クラウド / OpenAI 互換 LLM | 既定は Qwen API、または任意のエンドポイント/キー/モデルを入力 | RK3576・RK3588・Orin Nano 8GB・Orin NX 16GB・reComputer R2000 シリーズ | 不可 : モデル呼び出しにネットワークが必要 | 対話全体を最短で動かす場合、すでに契約しているモデルを使う場合 |
| 完全ローカル対話 | RK1828 / RM182X 上の Qwen3-4B、または Orin NX 16GB 上の Qwen3.5-4B | RK3588 + RK1828・Orin NX 16GB | 可能(イメージとモデル成果物のキャッシュ後) | 対話テキストを現場外に出せない場合、運用コストを固定したい場合 |
音声処理はどちらのプリセットでもローカルです。プリセットが決めるのは対話モデルの実行場所だけです。クラウドプリセットには上流の 推奨 バッジが付いています。
難易度は 中級、目安は約 30 分 です。完全ローカルのプリセットは、初回起動時にモデル成果物をダウンロードするため長くかかります。
よくある質問
発話中の割り込み(バージイン)に完全対応しています。
音声再生中もマイクの入力チャンネルが開いた状態を維持しているため、AI の応答途中で話しかけると音声生成が即座に中断され、再生キューがクリアされて次のターンへ移行します。
- 検証基準:デプロイガイドの手動テスト手順に基づき、連続 3 ターン、各回答開始から 0.5〜1 秒後の割り込み動作を確認済みです。
ハードウェア AEC(音響エコーキャンセラー)を搭載したマイクアレイが必須です。
一般的な USB マイクを使用すると、スピーカーから出力された自分自身の音声をマイクが拾ってしまい、AI が自身の発話に誤って割り込みをかけてしまいます。
- 推奨ハードウェア:reSpeaker XVF3800(検証済み標準マイクアレイ)
- その他のマイク:第 1 チャンネルの音声採取で動作可能ですが、現場の音響環境に応じた調整が必要です。
フルローカルプリセットであれば、オフライン環境で完全に動作します。
すべてのプリセットで音声入出力処理はエッジ側で実行されます。
- フルローカル構成:初回起動時のイメージ・モデル取得完了後は、外部通信なし(完全オフライン)で稼働
- クラウド構成:LLM 呼び出しのため、継続的なインターネット接続(API アクセス)が必要です。
最大 30 言語に対応しており、言語数とモデル規模に応じて必要なハードウェアが異なります。
- 英語・中国語:reComputer RK3576、RK3588、Orin Nano、Orin NX で利用可能(英語のみであれば reComputer R2000 でも動作)
- その他 28 言語:十分な計算資源を持つ reComputer RK3588 または Jetson Orin シリーズが必要
- 非対応構成:reComputer R2000 シリーズ上での中国語処理はシステムにより起動拒否されます。
実用的な文字認識率(CER)を担保できない構成での誤運用を防止するためです。
- 実測精度:実機検証において R2000 上の Whisper 中国語 CER(文字誤り率)は 35〜56% に達し、業務利用に耐えません。
- 事前チェック仕様:サービス起動前にハードウェアと選択言語の組み合わせを自動検証し、不良稼働を未然に防ぎます。
エッジ専用モデルの最適化により、主要ボード上で高い認識精度を達成しています。
- reComputer RK3576:中国語短文 CER 1.05%(10〜20秒音声で 9.62%)、英語短文 WER 3.65%(長文で 6.99%)
- reComputer J4012 (Orin NX 16GB):Qwen3-ASR 最適化モデルにおいて Golden Set で CER 0% を記録
※ 言語・ハードウェアの組み合わせ全 18 パターンのうち、10 パターンは実機デプロイ可能として検証済みです。
リアルタイム対話におけるターン終了検出(ポーズ検知)の設計に起因します。
- メカニズム:発話途中の無音(ポーズ)を検知するとその時点で 1 ターンと判定するため、息継ぎのある長文は前節のみで応答が開始されます。
- 評価上の見え方:全文を正解データとして採点すると見かけ上の誤り率が上がりますが、音声認識モデル自体の誤認識ではありません。
- 今後の改善:ポーズ間隔を跨いでターンを継続する柔軟な VAD チューニングを順次提供予定です。
OpenAI 互換の Chat Completions API に対応していれば、外部サービスと容易に統合できます。
対話モデルの接続先エンドポイントを自社サービスに向けるだけで接続が完了します。
- 対応サービス:ストリーミング対応の RAG サービス、AI エージェントフレームワーク、ロボット制御指令層など
- メリット:音声認識・合成レイヤーに手を加えることなく、そのままシームレスに差し替え可能です。
お探しの答えが見つかりませんか?
お問い合わせ
ハードウェアパートナーとしてうれしいです!