ローカル音声サービス

自作アプリケーション向けのローカル音声サービスです——音声を送ればテキストが、テキストを送れば音声が返ります。reComputer J40 / J30、reComputer RK3588 / RK3576、または Pi 5 上で動作し、初回デプロイ後はオフラインで利用できます。

再利用できる現場テンプレート

聞き取りと発話が必要で、音声をクラウドの音声 API に送れない製品向けです。

  • 音声で操作するロボット —— 発話コマンドがテキストになって制御ロジックに渡り、応答は音声で返ります。
  • キオスク端末・受付端末 —— 来訪者が声で尋ね、音声で答えを聞きます。
  • 産業現場の音声コマンド —— 画面に触れずに操作を実行します。
  • 音声ホストの共有 —— LAN 上の複数のデバイスが 1 台のエッジボックスに音声を送ります。

適さないケース:そのまま使える完成品の音声アシスタント。本サービスが担うのは聞き取りと発話だけで、対話ロジックやモデルは自前で接続します。
どう実現するか

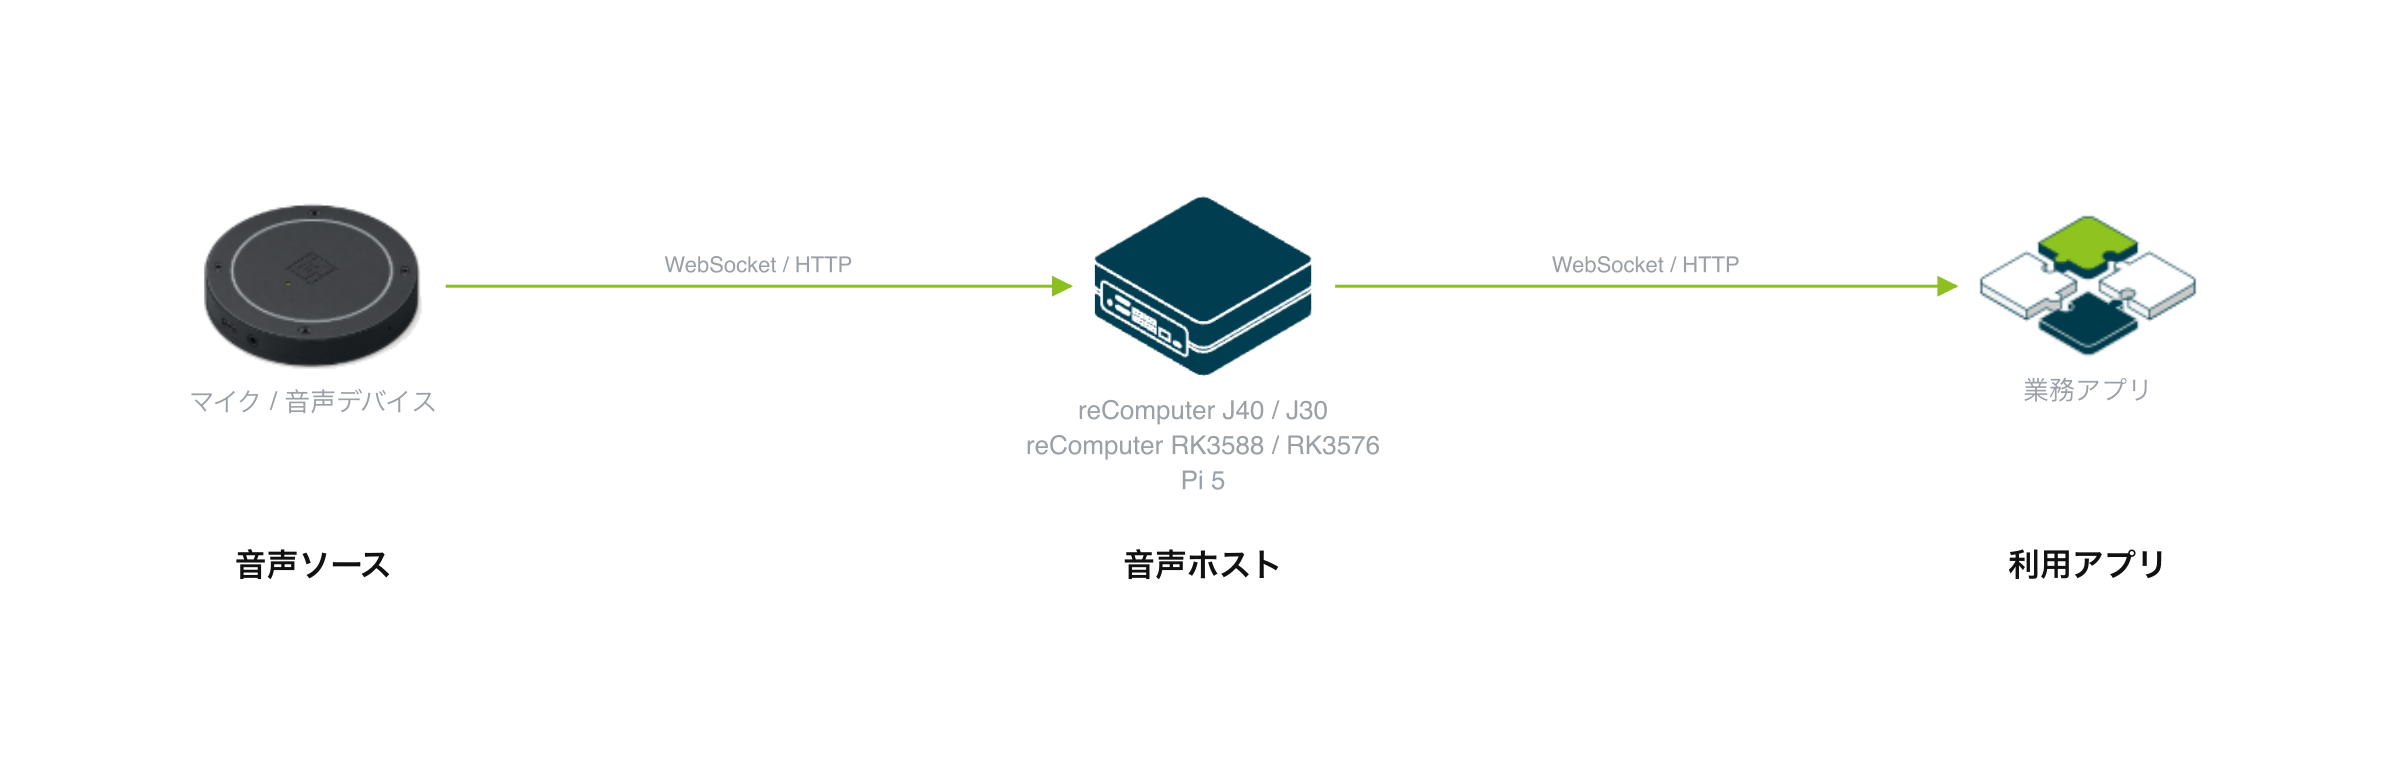
ローカル音声サービスの機器構成:マイクまたは他デバイスの音声が WebSocket / HTTP で音声ホスト(reComputer J40 / J30、reComputer RK3588 / RK3576、または Pi 5)に届き、アプリケーションは WebSocket / HTTP でテキストと音声を受け取る

3 つだけです。音声の入力元、認識と合成を行う 1 台のエッジホスト、LAN 経由でそれを呼び出すあなたのアプリケーション。音声とテキストはそのホスト内に留まります。インターネットが必要なのは初回デプロイ時、イメージとモデルのダウンロードのみです。

Audio Source

サービスは自前のマイクからではなく、あなたのプログラムから音声を受け取ります。

  • ホスト上のマイク —— あなたのプログラムが取得してストリームとして送ります。
  • 他デバイスの音声 —— ロボット、キオスク、Web ページが LAN 経由で送信します。
  • 録音済みファイル —— WAV をアップロードすると転写結果が返ります。

再生もあなたのプログラムの役目です。サービスは音声ストリームまたは WAV ファイルを返します。ユーザーが応答を割り込めるようにする必要がある場合は、ハードウェアエコーキャンセル付きのマイクを使ってください。この構成は Conversational Voice AI リファレンスデザインで扱っています。

どこまでできるか

クライアントが発話終了を通知した時点から、合成音声の最初のフレームまでを実測しています。対話モデルと無音待ちは経路に含みません。

利用者が得られるもの代表値機器
音声認識から合成音声の先頭まで(中国語+英語プロファイル、VAD と LLM を除く)58 ms p50reComputer J40 シリーズ(Orin NX 16GB)
認識誤り率(同プロファイル)10.5% CER p50reComputer J40 シリーズ(Orin NX 16GB)
音声認識から合成音声の先頭まで(Qwen3 多言語、VAD と LLM を除く)162 ms p50reComputer J40 シリーズ(Orin NX 16GB)

同じ測定で reComputer RK3588 は 528 ms、reComputer RK3576 は 1020 ms です。J40 では Qwen3 認識により誤り率が 5.3% CER まで下がります。

実際の製品では、ターン検出が待つ無音時間と対話モデルの応答時間が加わります。2 セッション同時実行は J30・J40・RK3588・RK3576 で動作しますが、Jetson では 2 セッション時に合成がリアルタイムに追いつきません。

何が取り出せるか

すべてのインターフェースは音声ホストのポート 8621 で提供されます。

インターフェース入力出力
ws://<host>:8621/asr/stream16 bit PCM の音声逐次届く認識テキストと確定フラグ
POST http://<host>:8621/asrWAV ファイル認識テキスト
POST http://<host>:8621/tts/streamJSON のテキスト再生可能な raw PCM ストリーム
POST http://<host>:8621/ttsJSON のテキストWAV ファイル 1 件
GET http://<host>:8621/health—認識と合成が準備できているか

統合点は自社アプリケーションです。 認識結果と合成リクエストの間に、対話モデル・ルールエンジン・ロボットのコマンド層を挟みます。

自社システムへの移植

再利用できる単位は「安定した HTTP / WebSocket インターフェースの背後にあるローカル認識とローカル合成」です。その間に何を置くかは自由です。

レイヤー移植時に必要な作業
4 種類のアクセラレータ上の認識と合成そのまま再利用
ポート 8621 のインターフェースそのまま再利用
音声プロファイル、話者、速度デバイス設定で選択
対話モデル、ルール、ロボットのコマンドここが自社製品の中身になります
マイク集音、再生、バージイン自社アプリで実装するか、Conversational Voice AI から始めます

適さない形態

  • 割り込み発話を標準で必要とする製品 —— エコーキャンセル付き集音とバージインを備えた Conversational Voice AI を使ってください。
  • Qwen3 の 52 言語リスト外の言語、または Pi 5 上で中国語・英語以外を扱う場合。

どう導入するか

構成と製品リストを確認し、デプロイガイドの手順に進みます。

ホストの選び方

  • 最小の遅延、または音声クローンが必要 → reComputer J40 シリーズ。発話終了から先頭音声まで 58 ms。代償はここで最上位のボード価格と 7.5 GB のディスク使用です。
  • 予算を抑えた Jetson → reComputer J30 シリーズ。音声プロファイルは J40 と同じです。代償は 8 GB ボードが必要で、他の GPU 処理と併用できないことです。
  • すでに Rockchip ボードを使っている → reComputer RK3588、コストを下げるなら RK3576。代償は先頭音声まで 528 ms / 1020 ms です。
  • 中国語と英語のみ、最小コスト → Pi 5(8GB)の CPU 実行。代償は多言語プロファイルが使えないことです。

導入前の条件:ホストへの SSH 接続、初回起動時のインターネット接続、選んだプロファイル分の空きディスク。

デプロイ構成

音声サービスをデプロイ

SSH 経由でストリーミング ASR + TTS サービスをエッジデバイスにデプロイ

2 ステップ · 約 15min

Edge Device
recomputer_j40
recomputer_rk3576
recomputer_rk3588

よくある質問

初回デプロイ後は使えます。初回起動時にイメージとモデルをダウンロードし、それ以降の認識と合成はすべてホスト上で完結します。

お探しの答えが見つかりませんか?
お問い合わせ
ハードウェアパートナーとしてうれしいです!
次へ