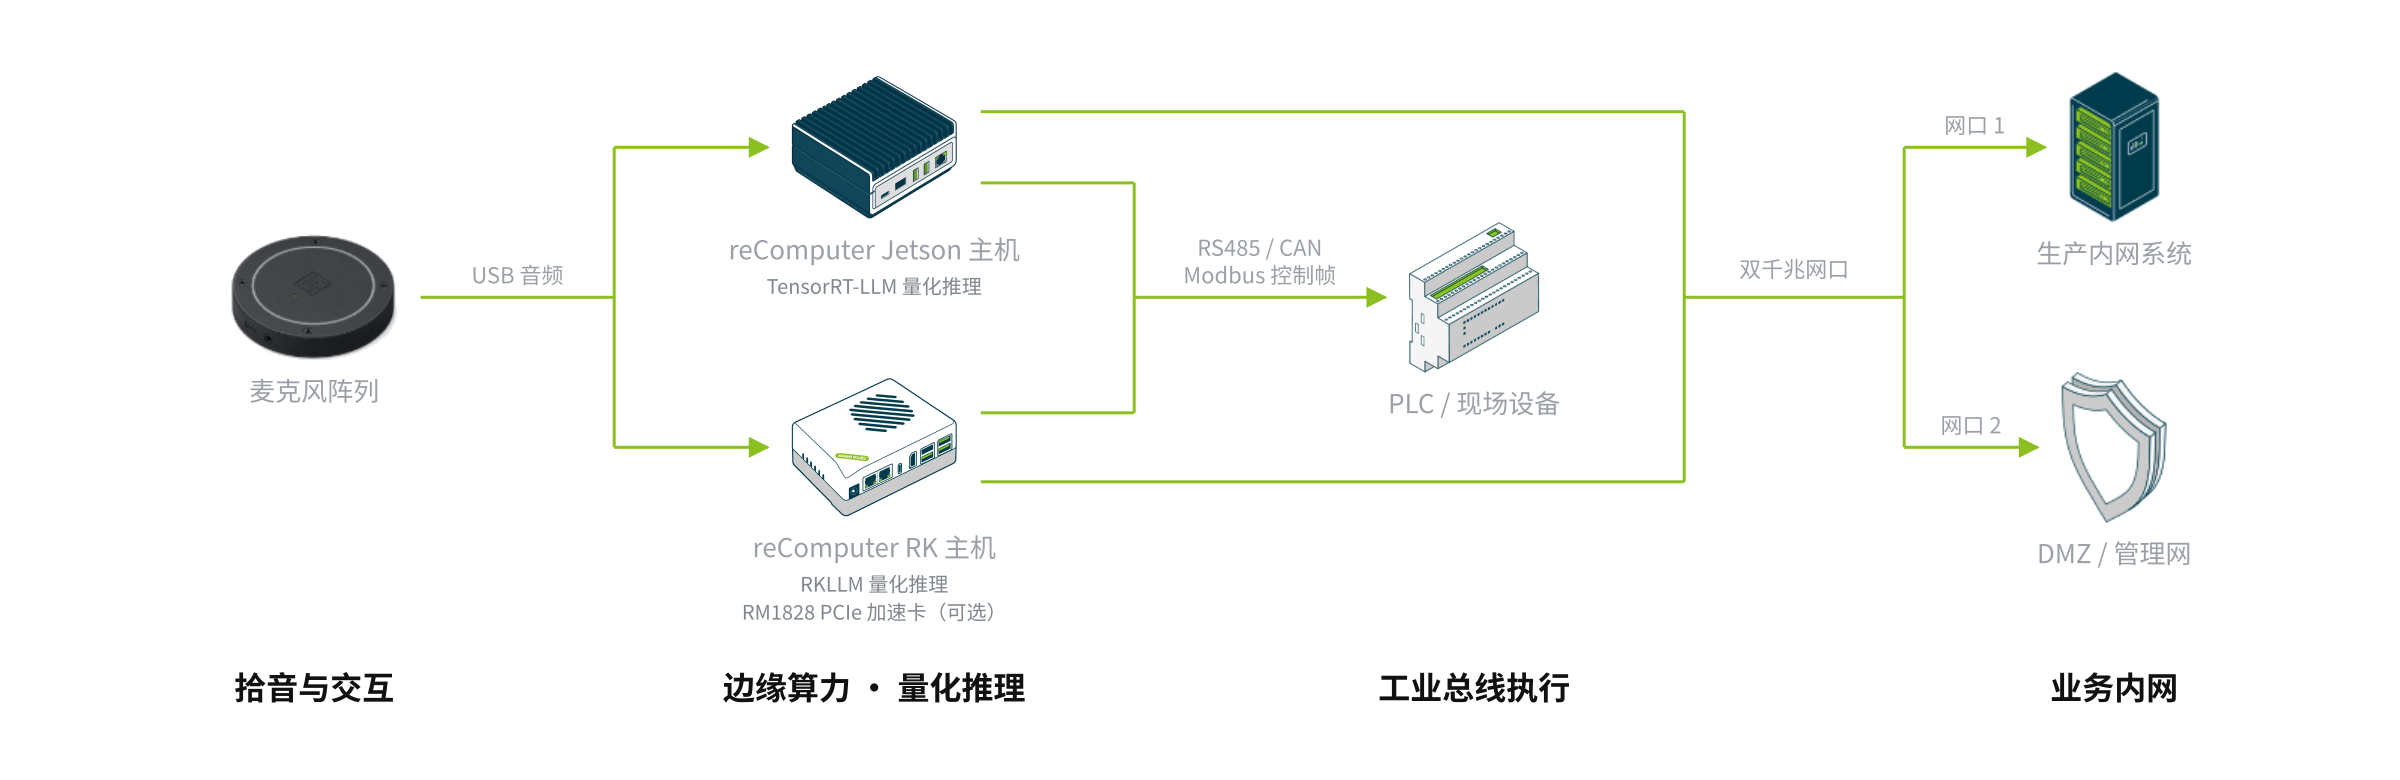
エッジ大言語モデル(On-Device LLM)は、製造ラインの検査記録、企業オフィス、スマート医療、重要インフラの設備制御現場へと本格導入が進んでいます。これらの現場において、大規模言語モデル(LLM)や音声認識モデル(Whisper)をエッジデバイスに展開する目的は、クラウドのような広範な百科事典的応答ではなく、3つの厳格な工学的制約を満たすことにあります。すなわち、データが外部ネットワークに一切出ないプライバシー保護と法規制遵守、パブリック回線から独立したミリ秒単位の確定的応答、そしてAPIトークン従量課金を排除した確定的コスト構造です。
しかし、現場導入のボトルネックはプロンプトエンジニアリングやエージェント設計ではなく、ハードウェア処理性能とメモリ帯域幅の不一致に起因することが大半です。帯域の狭い共有メモリ単板に無理に 7B モデルを配置して 5 tok/s 未満の応答不能に陥ったり、自己回帰デコード(Decode)のメモリ帯域制限を考慮せずピーク TOPS 値のみで機種選定を行ってしまうケースが散見されます。
本ガイドでは、統一実測条件(TensorRT-LLM および RKLLM)に基づき、タスク分解からメモリ帯域評価、ハードウェア適合に至る選定手法を解説します。併せて主要エッジデバイスの実測データと物理ネットワーク分離仕様を提示します。本稿の評価データはすべて Seeed Studio の reComputer シリーズ(2.2 TOPS〜275 TOPS)の実測値に基づいています。単一製品ファミリを用いることで、放熱構造や電源モード、ドライバや量子化カーネルの差異によるブレを排除し、公平な横断比較を可能にしています。解説する選定ロジックと工学的原則は特定のメーカーに依存せず、汎用エッジシステム全般に適用できます。
結論速報:機種とモデルの選定マトリクス
以下は本稿で導出する推奨構成一覧です。測定条件はINT4 量子化(AWQ または W4A16)、Power Mode = MAXN、入力 512〜2048 トークン、生成 128 トークンで統一しています。
| 業務タスクと要件 | 推奨ハードウェア | 処理性能とアーキテクチャ | メモリ構成と帯域幅 | 推奨モデルと量子化 | 実測デコード速度 | ハードウェア参考価格帯 | |
|---|---|---|---|---|---|---|---|
 | 超低消費電力・単一作業コマンド解析 | reComputer RK3576 | 2.2 TOPS (RK3576 NPU) | 4GB / 8GB LPDDR5 | Qwen2.5-0.5B / 1.5B (W4A16) | 0.5B: 35.2 tok/s;1.5B: 19.6 tok/s | 約 60–210 |
 | エッジ制御・機器 HMI 中枢 | reComputer RK3588 | 6.0 TOPS (RK3588 3-Core) | 8GB / 16GB LPDDR4x | Qwen2.5-1.5B / 3B (W8A8/W4A16) | 1.5B: 16.5 tok/s;3B: 11.5 tok/s | 約 80–360 |
 | 軽量エッジアシスタント・小規模 RAG | reComputer J3011 | 40 TOPS (Orin Nano 8G) | 8GB UMA (68 GB/s) | Qwen2.5-1.5B / 3B (INT4-AWQ) | 1.5B: 38.5 tok/s;3B: 22.5 tok/s | 約 00–1000 |
 | 社内ナレッジベース・音声中枢(主力) | reComputer Super J4012 | 100 TOPS (Orin NX 16G) | 16GB UMA (102.4 GB/s) | Qwen2.5-7B / Llama-3.1-8B (INT4) | 7B: 22.5 tok/s;8B: 23.5 tok/s | 約 00–1800 |
 | 高帯域 7B 専用推論アクセラレーション | RK3588 + RM1828 カード | 3D積層 NPU チップ | 1 TB/s 3D積層帯域 | Qwen2.5-7B / ChatGLM3-6B (W4A16) | 7B: 50–61 tok/s(Prefill: 800+) | 本体 約 80+;カード別途問合せ |
 | マルチモーダル・多拠点集約クラスタ | reComputer J5012 | 275 TOPS (AGX Orin 64G) | 64GB UMA (204.8 GB/s) | Qwen2.5-14B / Qwen3.5-27B (INT4) | 14B: 24.5 tok/s;27B: 14.5 tok/s | 約 800–4800 |
注:参考価格は単体ハードウェアの導入目安(2026年11月時点)です。ストレージ仕様、冷却構成、調達数量により変動するため、正式見積は公式ストアまたは営業窓口にご確認ください。
上記マトリクスを変更する3つの重要境界条件:
- 同一端末で Whisper 音声認識とベクトル検索を併用する場合:ユニファイドメモリ 16GB 以上の機種(Orin NX 16GB など)が必須です。8GB 機種では 7B INT4 モデル(約 5.2GB 消費)展開後の空き容量が不足し、Whisper-large-v3 の起動時に OOM(メモリ枯渇)を招きます。
- 多拠点からの同時並行リクエスト:自己回帰デコード処理は逐次計算です。単一ホストで 4 並行以上の同時応答を処理する場合は、204.8 GB/s 帯域を持つ J5012 を採用するか、ステーションごとに J4012 を分散配置してください。
- 高機密・物理完全閉域網の要件:M.2 Key-E スロットから無線カードを物理脱着可能で、独立したデュアル物理 GbE ポートを備えた産業用モデル(reComputer Industrial / Super)を選定する必要があります。
🤖 AI ソリューション選定アシスタント(Solution-CLI):
- 端末即時照会:
npx @seeed-studio/solution-cli hub get on-device-lm --sections products,architectureを実行することで推奨機器とハードウェア構成を一覧表示できます。- 自然言語による問合せ:Claude Code、Codex、Antigravity、Cursor などの環境から直接問合せ可能です(例:「Qwen2.5-7B をローカル閉域網で Modbus 制御と併せて運用する推奨機器と電源構成は?」)。アシスタントが負荷と必要部材を自動算出します。詳細は solution-cli 公式ドキュメント をご参照ください。
- ソリューションページ:リアルタイムベンチマークと製品仕様は エッジ生成AI・ローカルLLMソリューション をご覧ください。
💡 関連ソリューションおよび実案件リファレンス: 本稿で詳述したエッジ AI 処理基盤は、以下の業界ソリューションおよび導入実績のあるリファレンス設計に直接組み込まれています:
- 業界ソリューション:対話型音声 AI ソリューション、対面接客音声インテリジェンス、スマート倉庫管理ソリューション。
- 現場導入リファレンス設計:対話型音声 AI リファレンス設計、スマートバッジ引継ぎ音声文字起こし。
なぜ大規模言語モデルをエッジで動かすのか
エッジ完結型アーキテクチャ:マイク収音からローカル Whisper 文字起こし、量子化 LLM 推論、Modbus PLC 駆動まで現場内で完結
パブリッククラウド API の利用と比較して、ローカル展開には製造現場や企業利用における4つの決定的優位性があります:
- データが物理的に外部へ流出しない:制御ログ、医療カルテ、独自設計図面、機密契約書は、トークン化から推論、ベクトル検索に至る全工程をローカル物理メモリ上で完結し、一切インターネットを経由しません。
- ミリ秒単位の確定的応答時間(TTFT):クラウド API はパブリック回線の往復遅延(RTT)やサーバ側キューイングの影響を受け、初字生成までの待機時間が 800ms から数秒まで大きく変動します。ローカル実行により通信遅延を排除し、35ms〜150ms の安定した初回応答を維持します。
- 回線途絶時でも業務が継続可能:地下施設、船舶、遠隔変電所、またはネットワーク障害時であっても、現場の機器制御やドキュメント参照を止めることなく運用できます。
- 利用頻度に比例する課金コストの排除:現場の数百〜数千箇所で 24時間365日 会話型インターフェースを稼働させた場合、クラウド従量課金は運用コストを著しく膨らませます。エッジ導入は一回限りの設備投資であり、運用開始後のトークン追加費用はゼロです。
エッジ機器選定の4ステップ
導入検討に際しては、以下の4ステップで仕様を固めます:
ステップ1:タスクに応じたモデルパラメータ規模の決定
- 0.5B – 1.5B(エッジ制御・単一意図抽出):決まった意図の分類、キーワード抽出、定型制御コマンドの JSON 変換(例:「第2コンベアを停止し冷却ポンプを起動」)。RK3576 などの超低消費電力ボードでもフルスピードで稼働します。
- 3B – 4B(軽量対話・要約):文脈理解と簡易推論に対応。現場オペレーターのトラブルシューティング支援や交替時の日報要約に適します。
- 7B – 8B(エンタープライズ中核標準):業界で最も広く利用される実用サイズ(Qwen2.5-7B、Llama-3.1-8B など)。プログラムコード生成、ファンクションコーリング、長文理解、ローカル RAG に対応し、企業内ナレッジ検索の要件を高い精度で満たします。
- 14B – 27B(高精度専門推論):数十ページに及ぶ技術仕様書の照合や高度な原因分析。64GB ユニファイドメモリを備えた最上位エッジプラットフォーム(reComputer J5012 / AGX Orin 64GB)が必要です。
ステップ2:「メモリ帯域の壁」の理解
LLM の推論には Prefill(プロンプト処理) と Decode(自己回帰逐次生成) の2つのフェーズがあります:
- Prefill フェーズは演算受限(Compute-Bound)であり、TOPS 値が高いほど短時間でコンテキストを処理できます。
- 一方、Decode フェーズはメモリ帯域幅受限(Memory-Bandwidth Bound)です。1 トークン生成するごとに、モデル全体の重みをメモリから演算レジスタへ逐一読み出す必要があります。そのため、生成速度(tok/s)は公称 TOPS 値ではなく、ハードウェアのメモリバス帯域幅によって決定されます:
$$\text{理論最大生成速度 (tok/s)} \approx \frac{\text{メモリ帯域幅 (GB/s)}}{\text{量子化後モデル容量 (GB)}}$$
7B INT4 モデル(約 4.5GB〜5.2GB 消費)の場合:
- 共有 LPDDR4 バス(帯域約 30 GB/s)の標準ボードでは、デコード速度は 4〜11 tok/s に制約されます。
- 102.4 GB/s 帯域を持つ Orin NX(reComputer Super J4012)では、22.5 tok/s の生成が可能です。
- 3D 積層メモリ(帯域 1 TB/s)を備えた RM1828 専用アクセラレータカードでは、50〜61 tok/s へと跳ね上がります。
結論:機種選定時には公称 TOPS 値の前に、必ずメモリバス帯域幅を評価基準として確認してください。
ステップ3:量子化方式の比較と採用
実運用では INT4-AWQ または W4A16 の量子化が事実上の標準です:
- メモリと容量の半減:7B の FP16 元モデル(約 14GB)を 4.5GB〜5.2GB に圧縮。16GB エッジ機で Whisper やベクトル検索エンジンと共存させることが可能になります。
- 1.5倍〜2.2倍の高速化:専用の逆量子化融合カーネル(TensorRT-LLM CUTLASS / AWQ ランタイム)により、FP16 実行時と比べて大幅な速度向上が得られます。
- 高精度の維持:現代の AWQ 手法では、ベンチマークテストにおける FP16 からの精度劣化は通常 1% 未満に抑えられています。
ステップ4:ストレージと実行メモリの算出
エッジシステム構築にあたっては、以下の3層の容量を確保します:
- OS と基盤環境:Ubuntu ルートファイルシステム、CUDA/cuDNN ドライバ、Docker ランタイム、推論エンジン(15GB〜25GB)。
- モデル重みとトークナイザ:7B INT4 モデルで 5GB、Whisper-large-v3 や BGE-M3 埋め込みモデルの併用でさらに 4GB〜6GB。
- KV Cache と動的バッファ:文脈長に応じて動的に増加します。7B モデルの場合、2048 トークンで 0.5GB〜1GB を消費します。
選定結論:標準搭載の 64GB/128GB eMMC/NVMe は OS 実行領域専用とし、本番導入時は 512GB または 1TB の産業用 M.2 2280 NVMe SSD を追加してください。
ハードウェア実測性能と選定データ
1. NVIDIA Jetson シリーズ実測ベンチマーク(TensorRT-Edge-LLM)
NVIDIA Jetson Orin は CPU-GPU ユニファイドメモリアーキテクチャ(UMA)を採用しており、Ampere(sm_87)向け TensorRT-LLM 最適化により優れたエッジスループットを発揮します。
評価条件:JetPack 6.x、CUDA 12.6、TensorRT-LLM、Power Mode = MAXN、入力 512〜2048 トークン、生成 128 トークン。
| ハードウェア | メモリ仕様と帯域幅 | テストモデル | 量子化 | 実効メモリ | 初字遅延 (TTFT) | デコード生成速度 | 推奨同時実行 | 選定の境界条件 |
|---|---|---|---|---|---|---|---|---|
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-0.5B | INT4-AWQ | ~0.8 GB | ~35 ms | 95.0 tok/s | 4 系統 | 推奨上限 3B、低遅延コマンド解析 |
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-1.5B | INT4-AWQ | ~1.6 GB | ~58 ms | 38.5 tok/s | 2 系統 | 高速応答、メモリ負荷小 |
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-3B | INT4-AWQ | ~2.6 GB | ~88 ms | 22.5 tok/s | 1〜2 系統 | 8GB ハードウェアにおける推奨上限モデル |
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-7B | INT4-AWQ | ~5.8 GB | ~215 ms | 12.5 tok/s | 単一タスク | 空きメモリ僅少、同時実行時に OOM リスク |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-1.5B | INT4-AWQ | ~1.6 GB | ~38 ms | 58.0 tok/s | 4 系統 | マルチチャネル推論の中核 |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-3B | INT4-AWQ | ~2.6 GB | ~58 ms | 38.0 tok/s | 4 系統 | 高速インタラクション処理 |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-7B | INT4-AWQ | ~5.2 GB | ~115 ms | 22.5 tok/s | 2 系統 | 主力推奨構成、Whisper 同時展開余力あり |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Llama-3.1-8B | INT4-AWQ | ~5.8 GB | ~135 ms | 23.5 tok/s | 2 系統 | 高度な論理推論とタスク実行 |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-14B | INT4-AWQ | ~10.5 GB | ~270 ms | 11.0 tok/s | 1 系統 | 高精度ドキュメント質疑応答 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Qwen2.5-7B | INT4-AWQ | ~5.2 GB | ~62 ms | 45.5 tok/s | 8 系統 (185 tok/s) | エッジサーバクラスタ中枢 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Llama-3.1-8B | INT4-AWQ | ~5.8 GB | ~55 ms | 46.0 tok/s | 8 系統 (175 tok/s) | 多拠点ワークステーション集約 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Qwen2.5-14B | INT4-AWQ | ~10.5 GB | ~118 ms | 24.5 tok/s | 4 系統 | 長文 RAG とクロスシステム照合 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Qwen3.5-27B | INT4-AWQ | ~17.0 GB | ~240 ms | 14.5 tok/s | 2 系統 | 27B モデルのローカル完全動作 |
2. Rockchip RK シリーズ実測ベンチマーク(RKNN-LLM)
Rockchip プラットフォームでは、オンボード NPU 単板と PCIe 3D 積層 NPU アクセラレータカードの2つの形態に対応しています。
評価条件:RKLLM v1.2.x および RKLLM3、NPU/CPU 最高周波数固定、標準 QA ベンチマーク。
| プラットフォームと形態 | テストモデル | 量子化 | メモリ消費 | 初字遅延 | デコード速度 | 単板比倍率 | アーキテクチャと選定のポイント |
|---|---|---|---|---|---|---|---|
| RK3576 単板 (2コア NPU 2.2 TOPS) | Qwen2.5-0.5B | W4A16 | ~0.9 GB | ~68 ms | 35.2 tok/s | 基準 | 消費電力数ワット、産業機器への組込制御 |
| RK3576 単板 (2コア NPU 2.2 TOPS) | TinyLlama-1.1B | W4A16 | ~1.3 GB | ~110 ms | 21.8 tok/s | 基準 | 低電力単一タスク処理 |
| RK3576 単板 (2コア NPU 2.2 TOPS) | Qwen2.5-1.5B | W4A16 | ~1.6 GB | ~125 ms | 19.55 tok/s | 基準 | 単板における推奨上限モデル |
| RK3576 単板 (2コア NPU 2.2 TOPS) | Qwen2.5-3B | W4A16 | ~2.5 GB | ~230 ms | 11.45 tok/s | 基準 | 速度低下あり、非リアルタイム照会向け |
| RK3588 単板 (3コア NPU 6 TOPS) | TinyLlama-1.1B | W8A8 | ~1.25 GB | ~140 ms | 24.21 tok/s | 基準 | 軽量 SLM の安定動作 |
| RK3588 単板 (3コア NPU 6 TOPS) | Qwen2.5-1.5B | W8A8 | ~2.47 GB | ~206 ms | 16.46 tok/s | 基準 | 単板主力モデルとして推奨 |
| RK3588 単板 (3コア NPU 6 TOPS) | Qwen2.5-7B | W8A8 | ~6.2 GB | ~980 ms | 4.2 tok/s | 基準 | 共有バス帯域の制限により生成速度が低下 |
| RM1828 PCIe カード (RK1828 3D積層 1 TB/s) | Qwen2.5-1.5B | W4A16 | 2.5 GB | ~18 ms | 120+ tok/s | 7.3倍 | メモリ帯域の壁を解消、超低遅延応答 |
| RM1828 PCIe カード (RK1828 3D積層 1 TB/s) | Qwen2.5-3B | W4A16 | 2.5 GB | ~25 ms | 87 ~ 102 tok/s | 8.5倍 | 高速な多往復対話 |
| RM1828 PCIe カード (RK1828 3D積層 1 TB/s) | Qwen2.5-7B | W4A16 | 5.0 GB | ~65 ms | 50 ~ 61 tok/s | 12〜14倍 | 7B モデルで 50〜61 tok/s、Prefill 800+ tok/s を達成 |
| RM1828 PCIe カード (RK1828 3D積層 1 TB/s) | ChatGLM3-6B | W4A16 | 5.0 GB | ~60 ms | ~55 tok/s | 11.5倍 | 長文 RAG コンテキストでも快適な初回応答 |
企業向け閉域網物理ネットワーク分離仕様
金融機関、防衛、発電所などの高度機密現場では、外部への無線電波漏洩を物理的に遮断した「完全閉域化」が求められます。reComputer シリーズでは以下の3層の物理セキュリティ対策を講じることが可能です:
1. 無線モジュールの物理的除去(RF Air-Gap)
- モジュール構造:
reComputer Super J4012 / J3011およびreComputer Industrialシリーズは、Wi-Fi / Bluetooth モジュールを独立した M.2 Key E スロットカード上に集約しています。マザーボード側には無線チップを直接実装していません。 - 分離手順:
- 出荷時仕様:あらかじめ無線モジュールを未装着とした有線専用モデルを指定可能;
- 現地施工:筐体ネジを外して M.2 Key-E カードを物理的に取り外すことで、不正無線接続や電波傍受のリスクを物理レベルで完全に排除します。
2. 独立デュアル物理 GbE による内外網分離(Dual-LAN DMZ)
- 物理ハードウェア独立性:それぞれ独立した MAC / PHY チップを持つ 2系統の物理 RJ45 ポートを搭載し、OS カーネルレベルで完全に分離されたネットワークスタックを保持します。
- ルーティング構成:
- LAN 1(生産OTネットワーク):固定プライベート IP を割り当て、PLC やセンサ、ローカルストレージへ直結。デフォルトゲートウェイを設定しないことで外部ルーティングを遮断;
- LAN 2(管理DMZネットワーク):ハードウェアファイアウォール経由でホワイトリスト指定された管理用端末のみ接続;
- OS間転送の無効化:OS カーネルで
net.ipv4.ip_forward = 0を固定し、ポート間のパケット転送を遮断します。
3. ハードウェアセキュアブートと完全オフライン保守
- ハードウェア Secure Boot:NVIDIA Jetson モジュール内のハードウェアヒューズ(eFuse)に企業独自の公開鍵ハッシュを書き込みます。検証署名のないブートローダやカーネルの読み込みをハードウェアレベルで拒絶します。
- 完全オフライン保守:遠隔 OTA サービスを無効化し、モデル重みの更新やナレッジ更新は、現地で許可されたエンジニアが暗号化物理ストレージまたは保護された Type-C ポートを経由して直接注入します。
開梱内容と必須アクセサリ確認表
現地納品および展開前に、以下の必要部材を必ずご確認ください:
- 電源アダプタ(重要確認事項):
reComputer Super J4012 / J3011の標準パッケージには本体のみが含まれ、電源アダプタは同梱されていません。導入時は必ず 19V 4.74A (90W) 電源アダプタ(SKU 313080684) と適合する AC ケーブルを併せて手配してください;reComputer Industrial R21 / J20は端子台給電のため、盤内より 12V〜24V DC を供給するか、DIN レール対応電源モジュールをご用意ください。
- NVMe SSD 増設:
- 標準の 128GB ストレージは OS および基本環境用です。LLM 重み、Whisper 音声モデル、ベクトル DB を配置するため、512GB または 1TB の産業用 M.2 2280 NVMe SSD を必ず増設してください。
- 設置金具と通風クリアランス:
- 制御盤への設置には DIN レールマウントキットまたは壁掛け金具を使用してください;
- MAXN 全負荷運転時は、排熱口周辺に最低 5cm の空間を確保してください。
測定条件と工学的境界について
- ソフトウェア構成:
- NVIDIA プラットフォーム:JetPack 6.0 / 6.1、CUDA 12.6、TensorRT-LLM 0.12+、Power Mode = MAXN、GPU クロック最大固定;
- Rockchip プラットフォーム:Linux 5.10 / 6.1、RKLLM Runtime v1.2.0 / RKLLM3、NPU クロック最大固定。
- シーケンス長と計測指標:
- 入力プロンプト長 512〜2048 トークン、出力生成長 128 トークン;
- 初字遅延(TTFT)は、プロンプトの最後のトークンを受信してから最初の出力トークンが生成されるまでの端点間所要時間を計測。
- 現場環境における性能マージン:
- 表中の値は室温 25°C での実験室測定値です。45°C を超える密閉制御盤内では、冷却不足によりサーマルスロットリング(保護減速)が発生し、生成速度が 10%〜20% 低下する場合があります;
- 4096 トークンを超える長文対話では KV Cache が直線的に増加するため、OOM 回避のために少なくとも 2GB〜3GB のメモリバッファを確保してください。
- アップストリームオープンソースおよび評価ツールチェーン:
- NVIDIA TensorRT-LLM 公式プロジェクト:github.com/NVIDIA/TensorRT-LLM(Jetson Orin 向け量子化ビルドおよびマルチストリーム評価基盤);
- Rockchip RKLLM 公式ツールチェーン:github.com/airockchip/rknn-llm(RK3576/RK3588 NPU および RM1828 拡張カード向け量子化変換環境);
- オープンソース基底モデル:Qwen2.5 は Alibaba Tongyi Lab、Llama-3.1 は Meta AI の公式オープン重みを使用。
企業向け ODM/OEM ハードウェアカスタマイズサービス
上記の標準選定マトリクスにおいて、現場の筐体スペース制約、特定フィールドバス数(複数系統の絶縁型 CAN/RS485 等)、特殊電源仕様(9〜36V 産業用広電圧または車載電源)、保護等級(IP66/IP67 ファンレス密閉設計)、専用モデルの工場出荷時プレインストールなど、既製モデルで充足できない要件がある場合、Seeed Studio は柔軟な ODM/OEM カスタマイズサービスを提供しています:
- キャリアボード・基板設計カスタマイズ:Jetson Orin または Rockchip SoC を基盤に、特定インターフェースの増減、専用センサー拡張コネクタ、PCIe アクセラレータスロットを追加;
- 産業用筐体・外装設計:企業専用カラーリング、耐震ファンレスアルミ筐体、ブランドロゴのレーザー刻印、専用個別梱包に対応;
- ファームウェアおよびモデルイメージ事前書き込み:最適化済み TensorRT-LLM / RKLLM ランタイム、量子化モデル重み、推論コンテナを工場出荷時に事前格納し、現場での即時稼働を実現。
具体的なカスタマイズ仕様の検討や量産スケジュールについては、Seeed Studio ハードウェアカスタマイズサービス をご確認いただくか、弊社のソリューションアーキテクトチームへ直接お問い合わせください。


